一种用Chrome扩展做自动化采集的方案
写爬虫时,有一类比较麻烦的情况:页面在浏览器里可以正常打开,换成脚本请求,却拿不到相同的内容。
有时返回的是一个等待执行 JavaScript 的页面,有时需要登录,有时还要先经过几个页面操作。即使把请求地址和参数复制出来,也不一定能在另一个环境里直接复现。
我写的 petty-spider 里有一个 Chrome 扩展,就是用来处理这类问题的。它直接在已经打开的网页里提取数据,再通过点击页面上的按钮继续采集。
这篇文章介绍为什么选择这个方案,以及单页提取、连续翻页和结果保存的实现思路。
直接利用已经打开的浏览器
如果目标页面通过一次 HTTP 请求就能拿到完整数据,那么直接请求、解析、保存,整个流程很清楚。
但当获取数据依赖浏览器里的状态时,需要处理的事情就会多一些。比如登录状态、前面的操作步骤,以及页面执行 JavaScript 后才出现的内容。
代理能够处理哪一部分问题
脚本访问失败时,代理是一个常见的处理方向。但是否有用,需要看失败发生在哪个环节。
如果问题与出口 IP、网络路径有关,调整代理可能有效。如果页面依赖登录状态、JavaScript 执行结果,或者前面的交互步骤,仅仅更换代理,通常还不足以拿到需要的数据。
比如,假设一个资料页面需要先登录,再选择某个分类,最后点击查询按钮。浏览器中显示的结果,已经包含了这些操作产生的状态。
在脚本里直接请求最后看到的 URL,可能只会得到登录页或一个空页面。即使请求成功,返回的 HTML 也未必包含浏览器中显示的内容。
要继续使用 HTTP 脚本,就需要弄清楚:哪些状态影响了请求,这些状态如何产生,后续请求又应该携带什么。
既然内容已经能够在浏览器里显示出来,就可以考虑直接从这个页面中读取。
复用当前会话和已有的页面流程
Chrome 扩展提供了 content script,可以访问网页的 DOM、操作页面元素,并通过消息与扩展的其他部分通信。这正好覆盖了采集过程中的几个基本动作。Chrome 官方文档
这样一来,使用流程就变成:
- 在浏览器里打开目标页面,完成必要的登录或前置操作。
- 启动扩展中的采集任务。
- 扩展读取当前页的数据,保存后继续操作页面。
- 任务结束后,将结果导出到本地。
网站自己的页面逻辑继续负责加载内容,扩展负责提取已经呈现的数据,以及执行后续操作。对于这类任务,可以少维护一套在脚本环境里重建会话和页面流程的代码。
登录是一个比较典型的例子。在独立脚本里维持登录状态,可能需要处理 Cookie、Token、过期时间,以及登录流程中的其他步骤。手动复制一次 Cookie 可以解决眼前的问题,但状态过期后,还需要重新处理。
使用扩展时,可以先在浏览器里正常登录,再启动采集任务。这里并不要求扩展把所有 Cookie 读取出来,再拼装一遍请求。页面本来就在当前浏览器会话中运行,扩展可以直接提取其中的 DOM 内容。
这对需要人工参与的前置流程也比较方便。比如先完成一次登录验证,或者手动选择查询条件,等目标内容显示出来后,再把后面的重复操作交给程序。整个过程可以从一个已经可用的页面开始,自动化需要覆盖的范围也随之缩小。
有些网站还需要先请求初始化信息,再生成参数,随后获取数据。如果直接调用接口,就需要理解并复现这段过程;通过扩展操作页面时,可以沿用已有的按钮或表单,让网站自己的逻辑处理后面的请求和渲染。
这会减少对底层请求细节的依赖,但仍然需要维护页面规则:内容在哪里,什么时候算加载完成,哪个按钮负责继续,以及什么时候应该停止。
这里也有一个前提:当前浏览器会话确实能够访问目标内容,扩展也获得了相应的页面访问权限。换成扩展,并不能保证所有页面都可以正常采集。
和浏览器自动化脚本如何取舍
浏览器自动化脚本同样能够执行页面操作,也可以通过适当的配置复用已有会话。这些需求并非只能通过扩展完成。
选择扩展,主要与任务的起点有关。
如果任务从“打开浏览器、进入网站、完成登录”开始,使用一套完整的浏览器自动化流程很自然。
如果用户已经打开了目标网页,已经登录,也已经完成前面的操作,那么扩展可以直接从这里接着执行。用户在当前标签页里启动任务,扩展读取当前内容,再完成后面的重复操作。
这类场景下,可以少处理一部分环境衔接工作:
- 不必额外准备一个独立的浏览器环境,再把当前访问状态迁移过去。
- 人工操作和程序执行可以在同一个标签页里交接。
- 执行过程中可以直接观察页面,遇到异常时停止任务、检查当前状态。
这些差异对于个人使用、临时采集,以及前置流程需要人工参与的任务比较有用。
如果已经有稳定的浏览器自动化环境,能够可靠地管理会话和页面操作,改用扩展未必能减少多少工作。扩展的价值取决于任务是否需要利用用户当前正在使用的浏览器。
另外,使用扩展也不能保证避开网站的自动化检测。它仍然需要遵守页面的访问条件,程序触发的操作也需要在目标页面上验证。
把单页采集写成一个策略
从单个页面来看,采集过程比较简单:
等待目标内容
    ↓
提取字段
    ↓
保存结果
    ↓
翻页,或者结束
petty-spider 将这些逻辑放在一个策略中。下面用一个假设的资料列表页说明,省略任务注册等代码:
const task = {
  id: 'record-list',
  label: '资料列表',
  urlPrefix: 'https://example.com/records',

  async beforeExtract({ waitFor }) {
    await waitFor('.record-list')
  },

  strategyMap: {
    records: {
      selector: '.record-list .record',
      list: true,
      parse(node) {
        return {
          title: node.find('.title').text().trim(),
          href: node.find('a').attr('href'),
        }
      },
    },
  },

  afterExtract: {
    click: '.next-page',
    delayMs: 3000,
    stopText: ['没有更多', '最后一页'],
  },
}
这个策略描述了几件事:在哪些页面执行,采集前等待什么,如何提取字段,以及采集完成后点击哪里。
选择器能够表达的部分用配置处理,需要清洗文本或组合字段时,就写一个 parse 函数。页面操作比较复杂时,afterExtract 也可以使用函数。
当前项目中的可运行策略随扩展一起打包,新增任务还需要接入注册和调度流程。上面的配置只是用来说明单页任务的组织方式。
另外,content script 默认运行在隔离的 JavaScript 环境中。它可以操作页面 DOM,但不能直接访问网页脚本里的变量。因此,这套实现主要围绕 DOM 提取和页面操作展开。Chrome 官方文档
用 AI 分析页面并编写策略
这种结构明确的策略,也适合交给 AI Agent 来编写。用自然语言说明目标网页、需要采集的字段、如何翻页、什么时候停止,以及结果的导出要求,就可以让它参考已有策略完成实现。
比如,对于上面的资料列表页,可以描述为:提取每条记录的标题和链接,等待列表加载完成后再采集,保存后点击下一页,遇到按钮禁用或“没有更多”时停止。Agent 可以根据实际页面或提供的 HTML 分析节点结构,确定选择器、等待条件和结束规则,再编写策略并接入任务注册与调度流程。
项目里也整理了一个用于创建抓取任务的 Skill,把字段解析、页面操作、结果导出和任务接入的约定放在一起,供 Agent 读取。这样,新增策略时可以沿用项目已有的执行方式。
对于页面结构和采集要求比较明确的任务,现在的 AI Agent 通常已经可以在一次任务中完成相关策略的分析、编写和测试。需要给它提供可访问的页面或页面样本、项目代码,以及执行相应检查的工具和权限。
测试时除了确认字段是否提取正确,还需要观察翻页后是否继续、到末页是否停止,以及导出的结果是否符合预期。如果 Agent 只能读取静态 HTML,就先验证字段解析;连续翻页和异步加载的行为,仍需要在实际浏览器里检查。
翻页之后,任务如何继续
连续采集看起来很像一个循环:
while (hasNextPage()) {
  await collect()
  await nextPage()
}
但如果 nextPage() 触发整页导航,旧页面中的执行环境就会结束,运行中的函数也无法继续留在原地等待。
因此,需要把任务状态放到页面之外。
在这个扩展里,content script 负责执行当前页的采集,后台负责保存任务状态和结果。新页面加载后,content script 再向后台查询是否还有任务需要继续:
当前页提取数据
    ↓
后台确认保存
    ↓
点击下一页
    ↓
新页面加载
    ↓
向后台查询任务
    ↓
执行新一页的采集
这里的顺序很重要:先确认数据保存成功,再执行翻页。否则,页面已经离开,当前页的数据却可能还没有保存下来。
后台本身也需要考虑生命周期。Manifest V3 使用 service worker 处理后台事件,它可能在空闲时被终止,全局变量不能承担持久保存任务状态的职责。Chrome 官方文档
所以,任务状态和采集结果保存在 chrome.storage.local 中,后台处理消息时再读取。
对于 AJAX 翻页,页面文档没有被替换,当前 content script 可以继续发起下一轮采集。不过,“点击完成”和“内容更新完成”是两个时机。当前实现包含等待元素和固定间隔的处理,遇到加载较慢的页面,仍然需要根据站点调整等待条件。
提取数据与操作页面要分开
采集时经常需要清洗页面内容,比如删除某些无关节点,再读取剩余文本。
如果直接修改真实页面,可能影响后续操作。某个看起来无关的容器里,也可能放着翻页按钮或其他交互元素。
petty-spider 的字段解析会基于当前页面 HTML 创建 DOM 副本。parse 中的删除、清洗等操作作用在副本上;点击、导航等动作则通过真实页面上的元素完成。
这样,提取数据时可以做局部处理,同时保留原页面的交互结构。
网站相关的选择器、字段解析、后续动作和自定义导出,也放在对应策略里。通用部分负责调度、保存和传递结果,不需要知道某个站点的具体页面规则。
自动化还需要知道什么时候停止
能够连续点击之后,还需要明确任务的结束条件。
当前实现会检查翻页入口是否存在、是否被禁用,以及按钮文字是否命中结束规则。后台还会比较本次结果与上一次结果:如果 URL 和数据都没有变化,就停止任务,避免在同一页反复采集。
这个判断只覆盖相邻两次结果。它无法发现经过很多页之后又回到前面某一页的所有循环情况,需要更完整的去重时,还要增加相应规则。
后台接收数据时,也会检查标签页、文档、本次运行和当前步骤的标识。因为页面导航、停止后重新开始等操作,都可能让旧消息晚于新任务到达。只看任务名称,无法判断这条结果现在是否还应该被接收。
这些处理会让代码比“提取后点击下一页”长一些,但它们决定了页面变化时,数据是否还能按预期保存。
采集结果按页保留,包含来源 URL、采集时间和字段数据。需要合并或整理格式时,在导出阶段处理,保留原始结果,方便之后检查。
这套方案的适用范围
最后,整体的扩展界面效果类似于
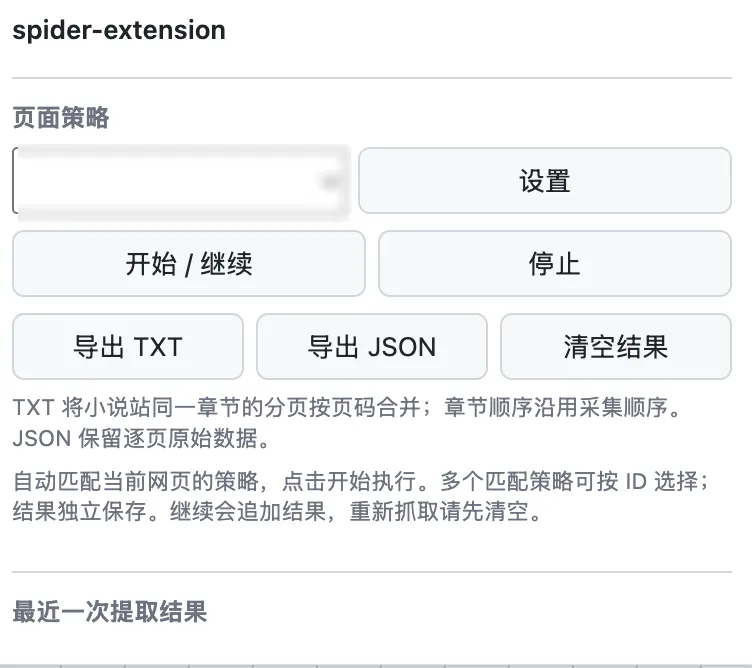
这种方式比较适合依赖现有浏览器会话、操作路径相对明确、采集规模有限的任务。用户可以先完成必要的前置操作,再把重复的提取和翻页交给扩展。
它也保留了页面自动化本身的限制:选择器会随页面改版失效,异步内容需要合适的等待条件,登录过期和交互验证仍然可能中断流程。任务也依赖浏览器和目标标签页保持可用。
如果已经有稳定的数据接口,直接请求通常会更简单;如果需要大规模并发和长期无人值守,还要另外考虑调度、资源和恢复机制。
petty-spider 的这个扩展提供了一种补充思路:当采集依赖网页中已经建立的状态时,可以把执行位置放到当前浏览器里,让扩展接着完成后面的重复操作。
你要请我喝一杯奶茶?
版权声明:自由转载-非商用-保持署名和原文链接。
本站文章均为本人原创,参考文章我都会在文中进行声明,也请您转载时附上署名。